Perplexity ra mắt Orchestrator API: Hạ tầng định tuyến LLM hợp nhất, giải bài toán Failover và chi phí token

Điểm nhấn cốt lõi (Key Takeaways)
- Khả năng failover độc lập: Giữ nguyên định danh mô hình nhưng hoán đổi linh hoạt nhà cung cấp hạ tầng (như chuyển từ Anthropic trực tiếp sang AWS Bedrock cho Claude) mà không phát sinh thêm bất kỳ phụ phí nền tảng nào.
- Khoảng cách hiệu năng thực tế: Dữ liệu vận hành thực tế cho thấy Azure đạt tốc độ sinh token trung vị (median output speed) nhanh hơn 27% so với OpenAI đối với GPT-5.6 Sol; trong khi Claude Opus 5.5 chia đều 15/30 ngày dẫn đầu tốc độ giữa Anthropic và AWS Bedrock.
- Định tuyến thông minh theo ngữ cảnh: Cơ chế perplexity/auto sử dụng mô hình quyết định (decision model) giúp vượt qua các rào chắn kiểm duyệt an toàn khắt khe trên Terminal-Bench 4.1, hoàn thành thêm +3 tác vụ nhờ tự động định tuyến sau khi bị từ chối (after_refusal).
Perplexity chính thức ra mắt Orchestrator API, cổng suy luận tập trung hỗ trợ tự động hoán đổi nhà cung cấp (failover) và định tuyến mô hình thông minh qua một endpoint duy nhất. Giải pháp này giúp các kỹ sư loại bỏ nguy cơ gián đoạn dịch vụ LLM, tối ưu độ trễ thực thi và hợp nhất toàn bộ chi phí sử dụng API đa nền tảng vào một hóa đơn.
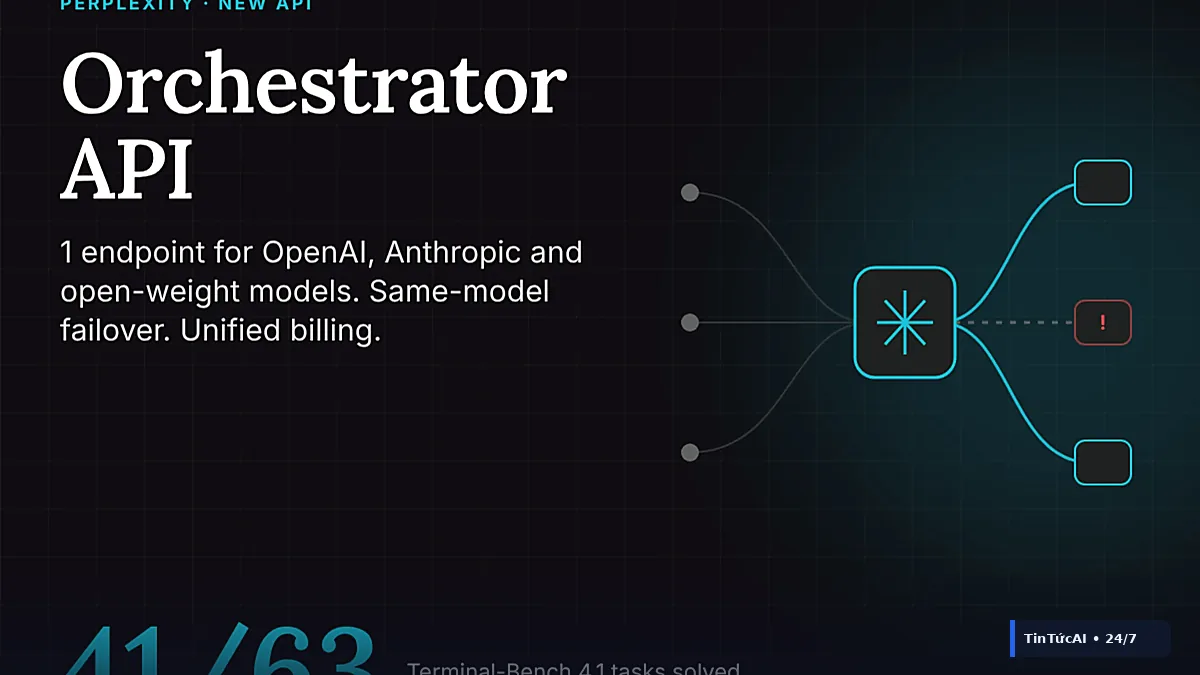
Perplexity vừa chính thức phát hành Perplexity Orchestrator API – cổng giao tiếp suy luận (inference gateway) tập trung, thiết lập một điểm cuối duy nhất (single endpoint) kết nối đồng thời các mô hình ngôn ngữ lớn tiên phong (frontier models) và mô hình trọng số mở (open-weight models). Được xây dựng từ chính lớp hạ tầng nội bộ đang phục vụ hơn 85 mô hình và hơn 12 nhà cung cấp dịch vụ suy luận của Perplexity, công cụ này giải quyết cùng lúc ba nút thắt lớn nhất của giới kỹ thuật AI hiện nay: tình trạng phân mảnh tích hợp, rủi ro đứt gãy kết nối do giới hạn tải (rate limit), và gánh nặng quản lý thanh toán từ quá nhiều nhà cung cấp đám mây.
Điểm nổi bật của Orchestrator API nằm ở khả năng tương thích trực tiếp (drop-in replacement) với các thư viện phổ biến. Hệ thống hỗ trợ định dạng chuẩn của OpenAI Chat Completions, OpenAI Responses qua base URL https://api.perplexity.ai/orchestrator/v1 và Anthropic Messages SDK qua base URL https://api.perplexity.ai/orchestrator. Các nhóm kỹ sư chỉ cần thay đổi API key và đường dẫn gốc mà không cần viết lại logic xử lý dữ liệu đầu vào hay đầu ra.
Cơ chế Failover đa hạ tầng: Chấm dứt nỗi lo gián đoạn dịch vụ
Khác với phương pháp fallback truyền thống thường tự động hạ cấp xuống một mô hình nhỏ hơn hoặc kém thông minh hơn khi xảy ra lỗi, cơ chế chuyển đổi dự phòng (failover) của Perplexity giữ cố định mô hình đã chọn và chỉ hoán đổi đơn vị cung cấp hạ tầng triển khai. Ví dụ, nếu một lệnh gọi đến Claude gặp sự cố kết nối hoặc vượt ngưỡng lưu lượng trên cụm máy chủ gốc của Anthropic, hệ thống sẽ lập tức chuyển hướng yêu cầu sang AWS Bedrock mà ứng dụng của người dùng không hề gặp lỗi gián đoạn.
Trong đợt đo kiểm dữ liệu lưu lượng sản phẩm thực tế kéo dài từ ngày 4/10 đến ngày 2/11/2026, Perplexity ghi nhận tỷ lệ thực thi thành công của các yêu cầu Claude và GPT khi đi qua Orchestrator API cao hơn đáng kể so với việc gửi trực tiếp tới từng nhà cung cấp đơn lẻ. Mức độ biến thiên tỷ lệ thành công theo ngày cũng được triệt tiêu đáng kể trong những thời điểm các nhà cung cấp đám mây gặp sự cố kỹ thuật.
Bên cạnh độ ổn định, hiệu năng độ trễ giữa các nhà cung cấp hạ tầng cũng có sự phân hóa rõ rệt: - Claude Opus 5.5: Trong chuỗi 30 ngày theo dõi, Anthropic chỉ giữ vị trí máy chủ có tốc độ phản hồi nhanh nhất trong 15 ngày, 15 ngày còn lại thuộc về AWS Bedrock. - GPT-5.6 Sol: Cụm máy chủ Microsoft Azure ghi nhận tốc độ tạo token trung vị (median output speed) vượt trội hơn tới 27% so với hạ tầng máy chủ của chính OpenAI.
Hiện tại, tính năng định tuyến tự động dựa theo độ trễ thời gian thực (Speed-aware routing) đang tiếp tục được Perplexity hoàn thiện để tích hợp sâu hơn vào hệ thống.
Định tuyến thông minh: Vượt rào cản kiểm duyệt trên Terminal-Bench 4.1
Bên cạnh tính năng chuyển đổi dự phòng cùng một mô hình, Perplexity đưa vào thử nghiệm tính năng định tuyến tự động (Model Routing preview). Lập trình viên chỉ cần khai báo tham số model: "perplexity/auto" và đính kèm một đối tượng routing chứa mô hình mặc định (default_model) cùng tối đa 5 nhánh định tuyến (routes), mỗi nhánh được định nghĩa bằng tên, mô tả chức năng và mô hình đích.
Một mô hình quyết định độc lập (decision model) sẽ đọc ngữ cảnh cuộc trò chuyện cùng các bản mô tả tuyến đường để đưa ra quyết định chuyển hướng tối ưu. Để đảm bảo tính khách quan và bảo mật, mô hình này hoàn toàn không nhìn thấy tên nhánh hay mã định danh mô hình đích. Khi không có tuyến nào khớp, hoặc khi mô hình quyết định gặp sự cố/quá thời gian chờ (timeout), yêu cầu sẽ được trả về xử lý tại default_model. Các tệp đầu vào đa phương tiện (media inputs) cũng tự động đi theo luồng mặc định này.
Các thông số phản hồi được trả về minh bạch qua tiêu đề HTTP gồm x-perplexity-autoroute-outcome, x-perplexity-autoroute-route và x-perplexity-autoroute-confidence. Cấu hình mặc định của hệ thống phân luồng các tác vụ phức tạp đến GPT-6.1 Sol và chuyển các yêu cầu cơ bản về GPT-6 Luna, đi kèm các bộ hồ sơ dựng sẵn gồm: Tiết kiệm chi phí (Lower cost), Cân bằng (Balanced), Chất lượng cao (Higher quality) và bản xem trước Tự động nỗ lực (Auto effort).
Trong bài kiểm thử trên tập dữ liệu con gồm 63 tác vụ của benchmark Terminal-Bench 4.1 chạy trong môi trường Claude Code, các rào cản an toàn tích hợp trên Claude Fable 5.2 đã vô tình từ chối nhiều tác vụ vô hại liên quan đến an ninh mạng và khoa học sự sống. Bằng cách thiết lập các nhánh định tuyến thông minh cho tác vụ bảo mật (security), sinh học (biology) và xử lý sau từ chối (after_refusal), Perplexity đã giải quyết thành công thêm +3 tác vụ so với ban đầu. Điều này chứng minh định tuyến động có thể cứu vãn các tác vụ AI Agent bị đình trệ do rào chắn kiểm duyệt quá mức.
So sánh kiến trúc: Perplexity Orchestrator và Cổng kết nối truyền thống
| Tiêu chí kỹ thuật | Kết nối API trực tiếp (OpenAI / Anthropic) | Cổng trung gian thông thường (OpenRouter / Portkey) | Perplexity Orchestrator API |
|---|---|---|---|
| Hạ tầng phục vụ | Đơn lẻ theo từng hãng | Đa dạng qua nhiều bên trung gian | 85+ mô hình từ hơn 12 nhà cung cấp lớn |
| Cơ chế Failover | Không có (phải tự code xử lý ở client) | Thường đổi sang model khác rẻ hơn | Giữ nguyên model ID, hoán đổi nhà cung cấp đám mây |
| Mô hình quyết định định tuyến | Thủ công bằng logic if/else | Dựa trên quy tắc tĩnh hoặc chi phí | Decision Model phân tích ngữ nghĩa động |
| Phụ phí nền tảng | Giá gốc từ nhà cung cấp | Thường cộng thêm phí % giao dịch | 0% phụ phí (thu đúng giá niêm yết của model đích) |
| Phương thức thanh toán | Quản lý nhiều thẻ và hóa đơn riêng biệt | Hóa đơn đơn lẻ qua cổng trung gian | 1 hóa đơn duy nhất, hỗ trợ thanh toán qua AWS Marketplace |
Về mặt chi phí, toàn bộ lượt gọi API được tính đúng theo đơn giá niêm yết công khai trên mỗi 1 triệu token của mô hình phản hồi cuối cùng mà không bị cộng thêm bất kỳ khoản phí dịch vụ nào. Chẳng hạn, mô hình mã nguồn mở perplexity/glm-5.3 có mức giá cố định là 1,4 USD/1M token đầu vào, 4,4 USD/1M token đầu ra và 0,26 USD/1M token đọc bộ nhớ đệm (cache read). Mọi chi phí được trừ trực tiếp vào hạn mức tín dụng trả trước của tài khoản Perplexity hoặc tính chung vào hóa đơn doanh nghiệp thông qua AWS Marketplace.
Góc nhìn phân tích: Bước chuyển mình chiến lược và tác động tới kỹ sư Việt Nam
Việc Perplexity tung ra Orchestrator API cho thấy tham vọng rõ ràng: công ty không còn muốn dừng lại ở vai trò một công cụ tìm kiếm hội thoại (Answer Engine), mà đang tiến thẳng vào lớp hạ tầng AI cốt lõi (AI Infrastructure). Bằng cách tận dụng chính năng lực vận hành cụm suy luận khổng lồ phục vụ sản phẩm tìm kiếm của mình, Perplexity đã mở ra một kênh doanh thu B2B trực tiếp, cạnh tranh sòng phẳng với các giải pháp cổng API như Cloudflare AI Gateway, OpenRouter hay AWS Bedrock.
Đối với cộng đồng kỹ sư và các doanh nghiệp công nghệ tại Việt Nam, sự xuất hiện của Orchestrator API mang lại ba giá trị thực tiễn lớn: 1. Gỡ bỏ rào cản thanh toán quốc tế: Thay vì phải duy trì nhiều thẻ tín dụng doanh nghiệp để thanh toán riêng lẻ cho OpenAI, Anthropic, Google Cloud và xAI, các nhóm phát triển chỉ cần quản lý một cổng thanh toán duy nhất hoặc kết nối trực tiếp qua tài khoản AWS Marketplace hiện có. 2. Tăng độ sẵn sàng cho hệ thống AI Agent: Khi phát triển các chuỗi tác vụ tự động nhiều bước (multi-step agents), chỉ một sự cố nghẽn mạng hoặc lỗi mã phản hồi 429/503 từ OpenAI cũng có thể làm đổ vỡ toàn bộ quy trình. Tính năng failover trong suốt giữa OpenAI và Azure, hoặc giữa Anthropic và AWS Bedrock giúp ứng dụng duy trì thời gian hoạt động (uptime) đạt chuẩn doanh nghiệp. 3. Tối ưu hóa ngân sách suy luận: Các startup có thể tận dụng các tuyến định tuyến để tự động đẩy các tác vụ trích xuất dữ liệu, dịch thuật đơn giản sang các mô hình mã nguồn mở giá rẻ như GLM-5.3, Kimi hay DeepSeek, và chỉ kích hoạt frontier models đắt đỏ khi xử lý logic suy luận phức tạp.
Làm thế nào để chuyển đổi mã nguồn hiện có sang sử dụng Perplexity Orchestrator API?
Nhà phát triển chỉ cần thay đổi API key và trỏ Base URL trong SDK hiện tại: sử dụng `https://api.perplexity.ai/orchestrator/v1` cho OpenAI SDK (tương thích cả Chat Completions và Responses) hoặc `https://api.perplexity.ai/orchestrator` cho Anthropic Messages SDK mà không cần thay đổi cấu trúc payload gửi lên.
Khi kích hoạt failover sang nhà cung cấp đám mây khác thì chi phí cuộc gọi có bị tăng lên không?
Không. Perplexity cam kết giữ nguyên đơn giá niêm yết trên mỗi triệu token của mô hình được gọi bất kể yêu cầu được xử lý qua hạ tầng của Anthropic hay chuyển đổi dự phòng sang AWS Bedrock, đồng thời không áp bất kỳ khoản phụ phí nền tảng nào trên lưu lượng.
Bạn thấy thông tin này như thế nào? Hãy để lại cảm xúc!
Tác giả chuyên sâu về nghiên cứu trí tuệ nhân tạo, quy trình Agentic và giải pháp tự động hoá quy mô lớn.