Hugging Face ra mắt Harness Adapters: Tăng vọt hiệu năng lập trình tự động, giảm hơn 50% chi phí gọi công cụ

Điểm nhấn cốt lõi (Key Takeaways)
- Qwen3.8-27B trang bị Harness Adapter tăng vọt độ chính xác từ 39,2% lên 64,7% (+25,5 điểm phần trăm) trên SWE-bench Pro và từ 40,0% lên 56,5% trên Terminal-Bench 2.1 dưới môi trường Pi.
- Cắt giảm từ 53% đến 73% số lượng gọi công cụ (tool calls) và tiết kiệm 44% đến 60% lượng token sinh ra trên mỗi tác vụ lập trình giải quyết thành công.
- Quy trình huấn luyện LoRA tối ưu trên 2 GPU NVIDIA B200 qua TRL AsyncGRPOTrainer, kết hợp kỹ thuật ghép Super-Adapter (rank 96) hoạt động đồng nhất trên cả 3 harness: Pi, Hermes Agent và OpenCode.
Hugging Face chính thức công bố kỹ thuật Harness Adapters, ứng dụng học tăng cường (RL) trực tiếp bên trong môi trường vận hành thực tế của AI Agent. Giải pháp giúp mô hình mã nguồn mở như Qwen3.8-27B tăng tới 25,5 điểm phần trăm trên SWE-bench Pro đồng thời cắt giảm hơn một nửa số lượt gọi công cụ và chi phí suy luận.
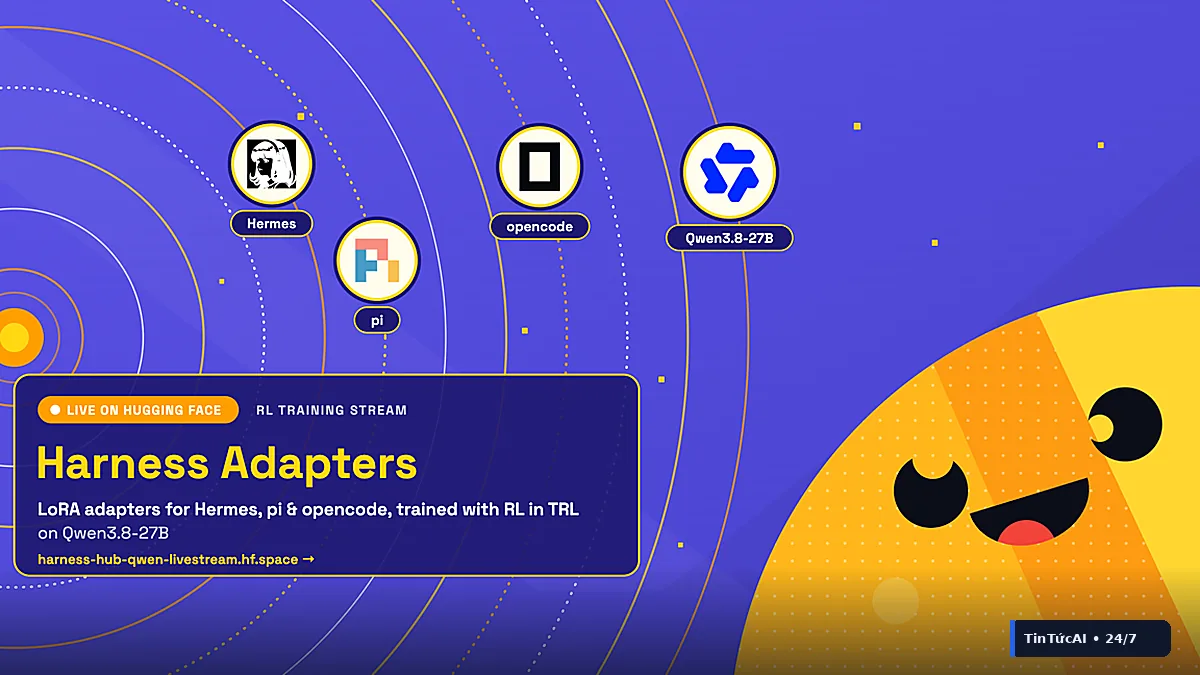
Phần lớn mô hình ngôn ngữ lớn hiện nay được tối ưu cho tác vụ đàm thoại tổng quát thay vì môi trường thực thi của tác nhân (Agent Harness). Khi vận hành trong các framework lập trình tự động như Pi, OpenCode hay Hermes Agent, mô hình thường gặp độ trễ lớn, lý luận rườm rà và tiêu tốn tài nguyên cho các lượt gọi công cụ (tool calls) thất bại. Nhằm khắc phục hạn chế này, Hugging Face đã giới thiệu Harness Adapters – kỹ thuật ứng dụng học tăng cường (RL) trực tiếp trong runtime thực tế, giúp nâng cao độ chính xác và giảm mạnh chi phí suy luận.
Nghịch lý môi trường Agent và giải pháp Harness Adapters
Các quy trình huấn luyện tác nhân truyền thống thường mô phỏng lại vòng lặp tương tác (agent loop) qua các giao diện framework như verl hay SkyRL-Gym, tạo khoảng cách lớn so với môi trường triển khai thực tế. Hugging Face đảo ngược hướng tiếp cận bằng cách đưa toàn bộ harness nguyên bản vào container Docker qua Harbor và OpenEnv, đồng thời ghi lại chính xác từng token phát sinh qua cổng proxy kết nối máy chủ vLLM.
Thử nghiệm trên mô hình Qwen3.8-27B làm rõ hiệu quả vượt trội. Ở trạng thái mặc định chạy trên harness Pi, Qwen3.8-27B chỉ đạt 39,1% trên Terminal-Bench 2.1 và tiêu tốn 2,9K token mỗi tác vụ. Khi đóng băng trọng số gốc và tích hợp bộ chuyển đổi LoRA huấn luyện bằng thuật toán GRPO (Group Relative Policy Optimization) ngay trong harness Pi, tỷ lệ giải quyết thành công đạt 55,0% pass@1, trong khi lượng token tiêu thụ giảm xuống còn 1,5K. Mô hình học được cách tinh giản suy luận và gọi chính xác công cụ ngay lần đầu.
Quy trình lọc dữ liệu khắt khe và hạ tầng AsyncGRPO
Huấn luyện RL cho tác nhân lập trình đòi hỏi môi trường thẩm định (verifier) chuẩn xác. Hugging Face tổng hợp dữ liệu từ ba nguồn: - SWE-smith: 717 tác vụ cấy lỗi mã nguồn trong Python và Go. - SWE-Gym (TaskTrove): 130 sự cố thực tế từ GitHub kèm bản vá. - Tasksmith (Repo2RLEnv): 24 bài toán tạo từ pull request đã đóng, nhắm vào các kỹ năng phức tạp như xử lý tệp tin và luồng HTTP.
Toàn bộ 871 tác vụ được kiểm định qua openenv validate. Nhóm áp dụng thêm bộ lọc độ khó (difficulty check) bằng cách cho Qwen3.8-27B chạy thử 4 đến 8 lần mỗi tác vụ. Do thuật toán GRPO tính điểm tương đối, các bài toán mô hình luôn giải đúng (151 tác vụ) hoặc luôn giải sai (120 tác vụ) bị loại bỏ vì không tạo tín hiệu học tập. Chỉ 171 tác vụ có độ khó vừa phải (Qualified) được giữ lại, kết hợp cùng 300 bài toán từ Termgrade thành tập dữ liệu cuối cùng.
Về hạ tầng, mỗi adapter được huấn luyện trên 2 GPU NVIDIA B200 (1 GPU phục vụ vLLM, 1 GPU cho huấn luyện) qua AsyncGRPOTrainer của TRL. Thiết lập bất đồng bộ giúp loại bỏ thời gian chờ rollout, tối ưu hóa quá trình huấn luyện với learning rate 2e-5 và context window 131.072 token. Công cụ safeagents kiểm soát 1,3 triệu lượt gọi công cụ và ngăn chặn 647 hành vi truy cập nguy hiểm.
So sánh hiệu năng trên SWE-bench Pro và Terminal-Bench 2.1
Các adapter chuyên biệt (specialist adapters) và siêu adapter (super-adapter) đều vượt trội mô hình gốc trên hai benchmark: SWE-bench Pro (51 bài khó nhất) và Terminal-Bench 2.1 (89 bài dòng lệnh).
| Môi trường (Harness) | Benchmark | Qwen3.8-27B (Gốc) | Qwen3.8-27B + Adapter | Giảm Tool Calls | Qwen3.8-27B + Super-Adapter (Thinking) |
|---|---|---|---|---|---|
| Pi (1.5.2) | SWE-bench Pro | 40,0% | 64,0% | Giảm 60% | 74,0% |
| Hermes Agent (v0.22.6) | SWE-bench Pro | 29,4% | 43,1% | Giảm 56% | 60,8% |
| OpenCode (2.2.7) | SWE-bench Pro | 35,3% | 51,0% | Giảm 72% | 66,7% |
| Pi (1.5.2) | Terminal-Bench 2.1 | 40,0% | 56,5% | Giảm 56% | 57,6% |
| Hermes Agent (v0.22.6) | Terminal-Bench 2.1 | 44,7% | 58,8% | Giảm 70% | 63,5% |
| OpenCode (2.2.7) | Terminal-Bench 2.1 | 47,6% | 52,4% | Giảm 53% | 58,5% |
Ở chế độ tắt thinking, adapter giúp tăng từ 14,1 đến 25,5 điểm phần trăm, đồng thời cắt giảm 53% - 73% lượt gọi công cụ và 44% - 60% token sinh ra trên mỗi tác vụ hoàn thành.
Hiện tượng "rò rỉ suy luận" và kỹ thuật ghép Super-Adapter
Phân tích quá trình thực thi chỉ ra hiện tượng "rò rỉ suy luận" (reasoning leakage): khi tắt thinking, adapter tự phát sinh các cụm từ đệm ngắn (như "..wait?", "..let me see") trước khi gọi lệnh. Đây là cơ chế suy luận ngầm giúp định hướng thao tác mà không tốn chi phí chuỗi suy nghĩ dài.
Đáng chú ý, độ tương đồng cosine giữa ba adapter chỉ đạt 0,01 - 0,02, cho thấy các cập nhật trọng số LoRA (rank 32) gần như trực giao. Hugging Face đã ghép ba adapter theo chiều rank thành một Super-Adapter (rank 96) với trọng số w = 0,5. Super-Adapter đạt điểm trung bình 52,5% trên Terminal-Bench 2.1 và tương thích tốt trên cả ba harness. Khi bật thinking, mô hình đạt đỉnh 74,0% trên SWE-bench Pro dưới harness Pi.
Ý nghĩa chiến lược và giá trị cho doanh nghiệp Việt Nam
Nghiên cứu của Hugging Face đánh dấu bước chuyển từ mở rộng quy mô tham số sang tối ưu hóa tương thích hệ thống tác tử (agent alignment). Việc phụ thuộc API thương mại như Claude 3.5 Sonnet hay GPT-4o đang tạo rào cản chi phí lớn khi ứng dụng agent quy mô rộng.
Với kỹ sư và doanh nghiệp công nghệ Việt Nam, Harness Adapters mở ra giải pháp tự chủ thiết thực. Thay vì chi trả hàng nghìn USD tiền API mỗi tháng, doanh nghiệp có thể tự triển khai mô hình nguồn mở 27B trên máy chủ cục bộ hoặc thuê hạ tầng GPU linh hoạt. Sử dụng bộ công cụ Harbor, OpenEnv và TRL AsyncGRPO để tinh chỉnh adapter theo kho mã nguồn nội bộ giúp bảo mật mã nguồn độc quyền, giảm hơn 50% chi phí điện toán mà vẫn sở hữu hệ thống hỗ trợ lập trình hàng đầu.
Harness Adapter có áp dụng được cho các tác vụ phi lập trình (non-SWE) hoặc quy trình tự động hóa văn phòng không?
Thử nghiệm trên 300 tác vụ AutomationBench của Zapier cho thấy adapter duy trì độ chính xác 23,7% - 27,0% (tương đương hoặc nhỉnh hơn nhẹ so với mức 23,0% của mô hình gốc), chứng minh mô hình không bị suy thoái năng lực tổng quát (catastrophic forgetting) dù chuyên biệt hóa sâu cho môi trường lập trình.
Kỹ sư có cần phải huấn luyện lại toàn bộ mô hình (Full Fine-tuning) khi đổi sang một Agent Harness mới?
Không. Nhờ kiến trúc LoRA rank 32 áp dụng cho toàn bộ lớp tuyến tính (all-linear) và cơ chế ghép siêu adapter (Super-Adapter rank 96, trọng số w = 0,5), các trọng số cập nhật gần như trực giao (độ tương đồng cosine chỉ 0,01 - 0,02), cho phép mô hình chạy tốt trên nhiều harness cùng lúc hoặc mở rộng sang framework mới chỉ bằng một adapter nhẹ.
Bạn thấy thông tin này như thế nào? Hãy để lại cảm xúc!
Tác giả chuyên sâu về nghiên cứu trí tuệ nhân tạo, quy trình Agentic và giải pháp tự động hoá quy mô lớn.