Hugging Face Ra Mắt Qwen3.8-27B-pi-adapted: Tối Ưu Lập Trình Lên 65%, Cắt Giảm 4,5 Lần Token

Điểm nhấn cốt lõi (Key Takeaways)
- Đột phá hiệu suất: Nâng tỷ lệ giải quyết tác vụ lập trình từ 39% lên 65% trên SWE-bench Pro mà không cần chuỗi suy luận dài, chạm mốc 66,7% khi bật thinking.
- Tối ưu tài nguyên vượt trội: Giảm số lượt tương tác trung vị từ 59 xuống 23 trên SWE-bench Pro và sinh ít hơn khoảng 4,5 lần lượng token so với base model.
- Kiến trúc mô-đun hóa: Ứng dụng PEFT LoRA trên mô hình lai Gated DeltaNet/Attention 64 tầng, cho phép một máy chủ chạy đồng thời nhiều adapter cho các harness như pi và OpenCode.
Hugging Face vừa phát hành Qwen3.8-27B-pi-adapted, bộ LoRA adapter tinh chỉnh bằng học tăng cường giúp nâng tỷ lệ giải quyết tác vụ mã nguồn của Qwen3.8-27B từ 39% lên 65%. Phương pháp tối ưu trực tiếp theo agent harness này giúp cắt giảm 4,5 lần lượng token và giảm hơn một nửa số lượt tương tác khi vận hành.
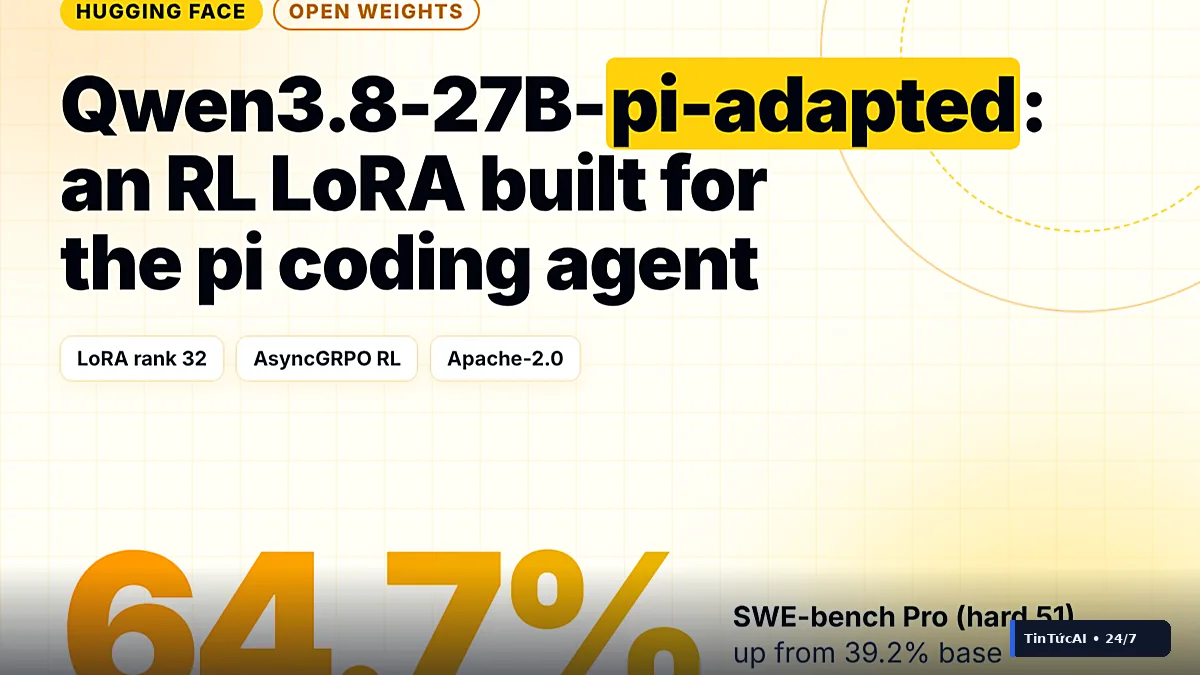
Nhóm harness-hub thuộc Hugging Face vừa phát hành Qwen3.8-27B-pi-adapted, bộ LoRA adapter biến mô hình nền tảng Qwen3.8-27B thành trợ lý chuyên dụng cho coding agent pi. Được cấp phép mã nguồn mở Apache-2.0, công trình này đánh dấu bước chuyển dịch quan trọng trong kỹ thuật xây dựng AI agent: thay vì tinh chỉnh mô hình hội thoại tổng quát, giới nghiên cứu chuyển sang tối ưu hóa mô hình tương thích trực tiếp với một môi trường thực thi (agent harness) cố định.
Kết quả thực nghiệm ghi nhận bước nhảy vọt: tỷ lệ thành công khi giải quyết tác vụ lập trình tăng từ 39% lên 65% trong môi trường pi harness, mang lại giải pháp kinh tế rõ rệt cho các kỹ sư muốn vận hành coding agent tự trị trên máy chủ nội bộ.
Bước chuyển dịch sang tối ưu hóa theo môi trường thực thi (Harness-Specific)
Qwen3.8-27B là mô hình nền tảng dạng đặc (dense hybrid), luân phiên xen kẽ các khối chú ý tuyến tính Gated DeltaNet với các khối Gated Attention trên toàn bộ 64 tầng mạng. Dù sở hữu năng lực suy luận mạnh, việc điều hướng công cụ dòng lệnh (CLI) trong agent harness đòi hỏi khả năng phản hồi có cấu trúc và tính nhất quán cao độ mà mô hình chat thông thường khó duy trì.
Adapter Qwen3.8-27B-pi-adapted ứng dụng kỹ thuật PEFT LoRA, can thiệp vào các ma trận chiếu cốt lõi: $q$, $k$, $v$, $o$, $gate$, $up$ và $down$. Khác với phương pháp hậu huấn luyện đại trà, nghiên cứu này theo đuổi nguyên lý: một LoRA adapter tương ứng cho mỗi cặp mô hình và harness. Adapter được tinh chỉnh riêng cho pi – bộ công cụ agent mã nguồn mở (giấy phép MIT) tích hợp CLI lập trình.
Thiết kế này mang lại lợi thế phân tách mô-đun vượt trội: nhà phát triển giữ nguyên mô hình nền Qwen3.8-27B và chỉ hoán đổi các adapter dung lượng nhỏ theo từng tác vụ. Nhờ dùng chung một base model, một máy chủ duy nhất có thể phục vụ song song cả pi lẫn OpenCode adapter cạnh nhau mà không nhân bản bộ nhớ VRAM.
Cơ chế huấn luyện RL khép kín và hệ thống lọc gian lận safeagents
Phương pháp luận của Hugging Face đưa quy trình học tăng cường (RL) vào thẳng bên trong môi trường harness nguyên bản, giải quyết các tác vụ có thể kiểm chứng thông qua bộ công cụ TRL. Mô hình học cách ra quyết định, thực thi lệnh shell và sửa lỗi mã nguồn dựa trên phản hồi thực tế từ môi trường.
Để ngăn chặn nguy cơ "lách luật nhận thưởng" (reward hacking) – lỗi phổ biến khi huấn luyện RL cho AI Agent – nhóm nghiên cứu triển khai proxy kiểm duyệt dựa trên luật mang tên safeagents. Toàn bộ lệnh gọi công cụ (tool calls) từ mô hình đều bắt buộc đi qua lớp kiểm soát này:
- Chặn truy cập tài nguyên đề bài: safeagents nhận diện và chặn đứng các yêu cầu tải trước đáp án benchmark từ Hugging Face Hub.
- Trừng phạt điểm số: Mọi chu kỳ thực thi (rollout) vi phạm sẽ lập tức bị chấm điểm 0.
- Uốn nắn hành vi: Áp lực từ thuật toán RL triệt tiêu xu hướng gian lận, buộc mô hình tập trung suy luận logic và sửa code thực tế.
Phân tích định lượng: Nhảy vọt lên 65% và bài toán tiết kiệm token
Đánh giá thực nghiệm trên hai bộ benchmark SWE-bench Pro và Terminal-Bench 2.1 (thiết lập 1 lần thử duy nhất trên pi harness) cho thấy adapter cải thiện toàn diện:
| Tiêu chí đánh giá | Base Model (Qwen3.8-27B) | Base Model + Thinking | Qwen3.8-27B-pi-adapted | Adapter + Thinking |
|---|---|---|---|---|
| Tỷ lệ giải quyết SWE-bench Pro | ~39.0% | 64.7% | 65.0% | 66.7% |
| Tỷ lệ giải quyết Terminal-Bench 2.1 | Mốc gốc | 54.2% | Ngang ngửa thinking | 56.6% |
| Lượt tương tác trung vị (SWE-bench) | 59 lượt | 59 lượt | 23 lượt (giảm 61%) | 23 lượt |
| Lượt tương tác trung vị (Terminal-Bench) | 18 lượt | 18 lượt | 8 lượt (giảm 55%) | 8 lượt |
| Lượng token sinh ra | Tiêu chuẩn | ~4,5x (chuỗi suy luận dài) | Tiết kiệm 4,5 lần | Tăng nhẹ theo trace |
| Tác vụ mới giải quyết thành công | Mốc tham chiếu | - | +15 bài SWE / +16 bài Terminal | - |
Hiệu quả tài nguyên (efficiency) là giá trị cốt lõi nhất. Trước đây, base model phải kích hoạt chế độ suy luận chuyên sâu (thinking on) mới đạt 64,7% trên SWE-bench Pro, đổi lại là lượng token khổng lồ và độ trễ cao. Với Qwen3.8-27B-pi-adapted, mô hình đạt tỷ lệ giải quyết 65% ngay ở chế độ tiêu chuẩn mà không cần thinking trace dài, cắt giảm khoảng 4,5 lần lượng token. Khi bật đồng thời cả thinking, độ chính xác chạm mức 66,7% trên SWE-bench Pro và 56,6% trên Terminal-Bench 2.1.
Đồng thời, số lượt tương tác trung vị (median turns) giảm mạnh từ 59 xuống 23 trên SWE-bench Pro và từ 18 xuống 8 trên Terminal-Bench 2.1 (trong khi chỉ để mất 2 bài ở mỗi bộ dữ liệu). Điều này chứng minh agent đã hiểu sâu cấu trúc lệnh của harness, hạn chế tối đa các chu kỳ thử-sai lãng phí.
Tác động chiến lược và cơ hội cho doanh nghiệp công nghệ Việt Nam
Sự ra đời của Qwen3.8-27B-pi-adapted mở ra hướng đi thực tế trước sức ép từ các API đóng đắt đỏ như Claude 3.5 Sonnet hay OpenAI o-series:
- Bảo mật mã nguồn tuyệt đối (On-premise): Các công ty gia công phần mềm và khối tài chính tại Việt Nam có thể vận hành coding agent an toàn ngay trong mạng nội bộ, loại bỏ nguy cơ rò rỉ dữ liệu khi gửi qua đám mây công cộng.
- Tiết kiệm chi phí hạ tầng: Định dạng GGUF kết hợp kiến trúc Gated DeltaNet và lượng tử hóa 4-bit cho phép mô hình 27 tỷ tham số chạy mượt mà trên GPU phổ thông như RTX 4090 (24GB VRAM) hoặc NVIDIA L4/A10G. Việc giảm 4,5 lần token giúp giải phóng tài nguyên GPU nhanh chóng, tăng năng lực phục vụ đồng thời cho các nhóm lập trình viên.
- Kiến trúc Agent đa nhiệm linh hoạt: Doanh nghiệp có thể duy trì một base model duy nhất và nạp động các adapter chuyên biệt (từ viết code với pi, OpenCode cho tới review tự động và kiểm thử CI/CD).
Qwen3.8-27B-pi-adapted khẳng định tương lai của AI Agent tập trung vào việc tối ưu hóa chính xác theo ngữ cảnh thực thi thay vì chỉ chạy đua quy mô tham số.
Tại sao việc tinh chỉnh theo harness cụ thể lại vượt trội hơn fine-tune hội thoại thông thường?
Phương pháp này huấn luyện mô hình thích ứng trực tiếp với tập lệnh CLI, phản hồi công cụ và cơ chế bắt lỗi của harness cụ thể. Nhờ đó, mô hình giảm thiểu các bước thử-sai vô nghĩa, cắt giảm 4,5 lần lượng token và giảm hơn một nửa số lượt tương tác trung vị.
Doanh nghiệp tại Việt Nam có thể vận hành Qwen3.8-27B-pi-adapted trên phần cứng nào?
Nhờ định dạng GGUF và kiến trúc PEFT LoRA, mô hình có thể chạy ổn định trên một GPU 24GB VRAM phổ thông như NVIDIA RTX 4090 hoặc L4/A10G khi kết hợp lượng tử hóa 4-bit, giúp tiết kiệm chi phí vận hành và bảo vệ tuyệt đối mã nguồn nội bộ.
Bạn thấy thông tin này như thế nào? Hãy để lại cảm xúc!
Tác giả chuyên sâu về nghiên cứu trí tuệ nhân tạo, quy trình Agentic và giải pháp tự động hoá quy mô lớn.